¿Se acaba la IA ilimitada? ChatGPT, Codex y el coste de los agentes
OpenAI unifica Chat y Work y compartirá el uso con Codex. Qué cambia, qué sigue incluido y por qué la IA se acerca a un modelo de capacidad.
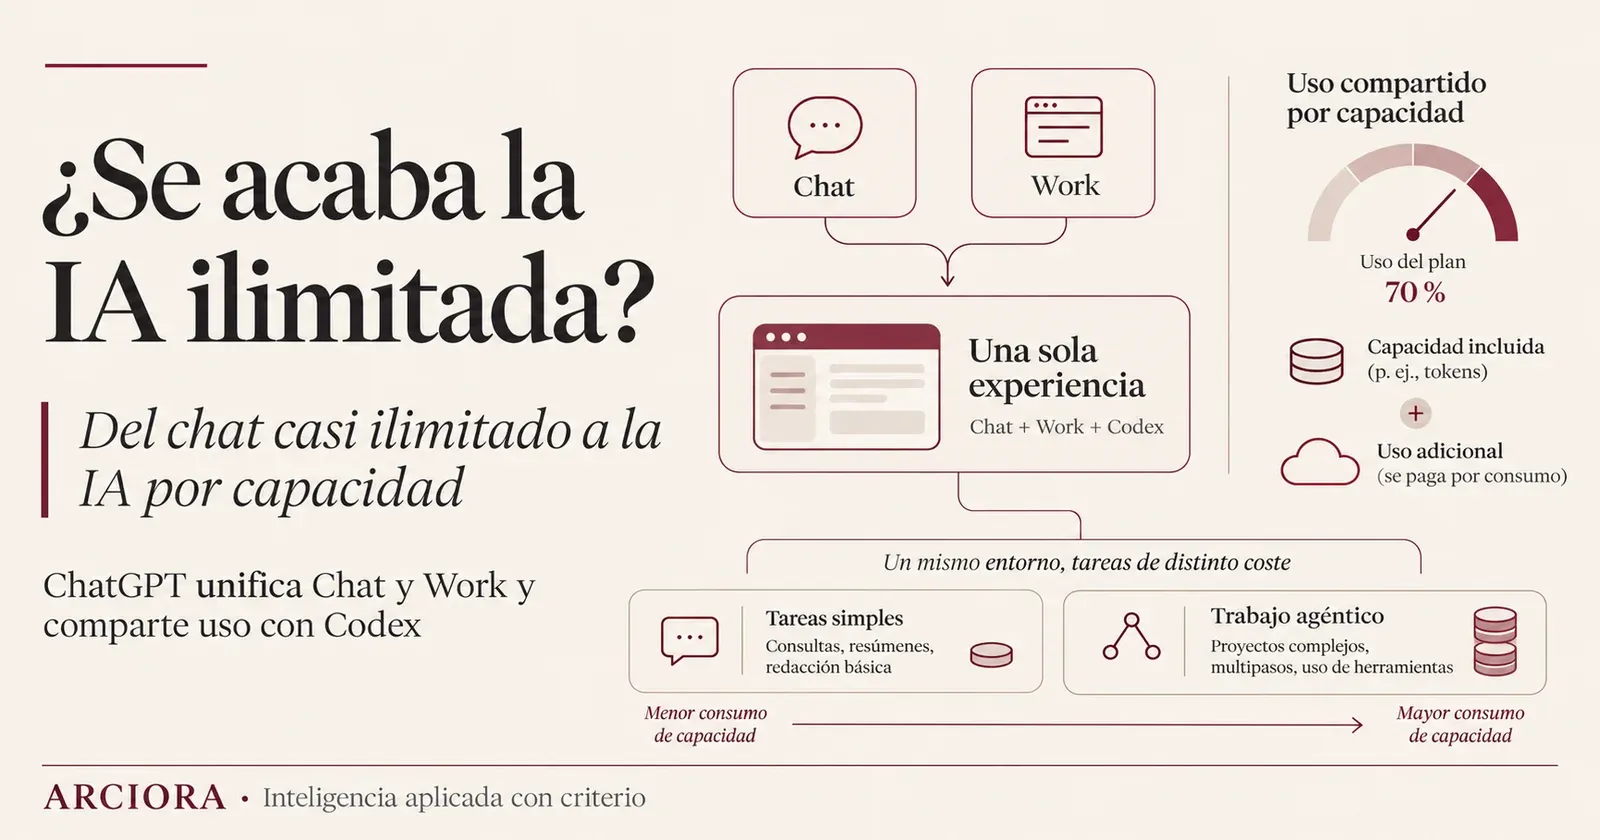
Durante mucho tiempo hemos utilizado los asistentes de inteligencia artificial con una sensación parecida a la de una tarifa plana: pagamos una suscripción, abrimos una conversación y pedimos lo que necesitamos. Una consulta sencilla, un análisis largo o una cadena de correcciones parecían formar parte del mismo servicio. Aunque siempre han existido límites, para muchos usuarios el coste de cada tarea era prácticamente invisible.
Esa experiencia está empezando a cambiar. OpenAI ha comunicado que, a partir de diciembre de 2026, los planes Plus, Pro y Business compartirán una misma asignación de uso entre ChatGPT y Codex, mientras prueba una experiencia que acerca el modo Chat y el modo Work en un mismo espacio. El consumo de esa asignación dependerá del modelo y de la tarea. Una pregunta breve y un agente trabajando durante horas no consumen necesariamente lo mismo.
Es una noticia relevante por sí misma, pero también apunta a una cuestión más profunda: la IA está pasando de venderse principalmente como una conversación a venderse, cada vez más, como capacidad para realizar trabajo.
La conclusión requiere matices. No ha desaparecido toda forma de uso ilimitado, OpenAI mantiene Instant fuera del nuevo cupo compartido y el lanzamiento se está anunciando como una transición progresiva. Tampoco hay pruebas suficientes para afirmar que todas las compañías de IA siguieron un plan coordinado de «regalar capacidad para enganchar usuarios». Lo que sí podemos analizar es cómo evolucionan sus productos y cómo empiezan a hacer más visible el coste del trabajo agéntico.
Qué ha anunciado realmente OpenAI
En una comunicación dirigida a usuarios de ChatGPT, OpenAI explica dos cambios relacionados, pero distintos.
El primero afecta a la experiencia de uso. La compañía probará con un grupo reducido una interfaz que reúna Chat y Work. La idea es poder pasar de consultar una cuestión a encargar un resultado —investigar, trabajar con archivos, preparar una presentación o construir una web— sin cambiar constantemente de espacio. Codex, orientado al desarrollo de software, seguirá disponible como experiencia diferenciada en la aplicación de escritorio.
El segundo afecta al consumo incluido en las suscripciones. OpenAI anuncia una asignación compartida entre ChatGPT y Codex para Plus, Pro y Business, con despliegue previsto a partir de diciembre. No se calcula únicamente en número de mensajes: el consumo se mide según los recursos de procesamiento, el modelo y la complejidad del encargo. La documentación oficial señala que intervienen los tokens, unidades de información que el modelo procesa y genera.
En lugar de prometer exactamente el mismo número de trabajos para todo el mundo, OpenAI indica que los usuarios podrán consultar su uso restante y cuándo se restablece en Ajustes → Uso. Cuando se agote una asignación aplicable, las opciones serán esperar, cambiar a un plan superior o comprar créditos para las funciones que admitan esa modalidad.
La compañía también espera que la mayoría de usuarios no tenga que esperar con más frecuencia que ahora para recuperar su cupo. Es una previsión de OpenAI, no un resultado que podamos dar por demostrado antes del despliegue.
La fuente más directa es la guía oficial de límites compartidos de ChatGPT y Codex. La documentación sobre Work y Codex explica, además, que las superficies y funciones disponibles dependen del plan y de cómo avance el lanzamiento.
Lo que NO significa el anuncio
El titular «se acaba la IA ilimitada» puede llamar la atención, pero sin contexto resultaría engañoso.
Instant no consume la nueva asignación compartida descrita por OpenAI. Por tanto, no es correcto afirmar que todas las consultas de ChatGPT empiezan a cobrarse por tokens o que cualquier conversación agotará el cupo de Codex.
Tampoco se ha anunciado un precio único por tarea, ni una cantidad universal de créditos por sesión aplicable a todos los planes. Los límites y las opciones de compra dependen de la cuenta y de las funciones. En productos con ventanas de uso, pueden existir límites de pocas horas y semanales, pero no debemos inventar importes o cuotas donde OpenAI no los publica de forma general.
Y un tercer matiz: combinar Chat y Work no es eliminar Codex, ni equivale a que el sistema vaya a decidir siempre y sin intervención qué modelo utilizar. La transición integra mejor distintas formas de trabajar y unifica parte del consumo; eso no sustituye los controles y elecciones de modelo que cada experiencia ofrezca.
El cambio confirmado es más preciso: determinadas capacidades avanzadas pasan a utilizar un presupuesto compartido, mientras el chat Instant mantiene un tratamiento diferenciado.
De contar mensajes a medir trabajo
Un mensaje de cinco palabras puede dar lugar a una respuesta corta. Otro puede pedir al agente que revise un repositorio, inspeccione cientos de archivos, ejecute pruebas y corrija fallos. Aunque ambos empiecen en una caja de texto, su coste no es comparable.
La diferencia procede de varios factores:
- Modelo utilizado: un modelo más potente puede requerir más recursos que uno rápido.
- Longitud del contexto: analizar documentos extensos consume más procesamiento que responder a una pregunta sencilla.
- Número de pasos: un agente puede hacer múltiples llamadas a herramientas y al modelo hasta completar la tarea.
- Verificación y correcciones: ejecutar pruebas, contrastar resultados o repetir una operación añade trabajo.
- Velocidad y configuración: algunas modalidades priorizan rapidez o mayor profundidad de razonamiento y pueden consumir más capacidad.
La documentación oficial de Codex en ChatGPT señala expresamente que las tareas prolongadas pueden consumir bastante más que una solicitud breve.
Así se entiende por qué empieza a resultar insuficiente vender toda la IA como si cada mensaje tuviera el mismo coste. La unidad útil no siempre es la pregunta: cada vez más, es el trabajo que el sistema consigue realizar.
Claude ya había avanzado hacia límites compartidos
OpenAI no es la primera empresa que comunica una organización del consumo entre distintas superficies de trabajo.
Anthropic explica en su documentación sobre límites de Claude que el uso de Claude, Claude Code y Claude Desktop cuenta para los límites del plan. En determinados planes existen ventanas de cinco horas y límites semanales. La longitud y complejidad de las conversaciones, el modelo y el esfuerzo seleccionado afectan al consumo.
La documentación sobre Claude Code y los planes de suscripción refuerza la misma idea: conversar y programar con agentes pueden consumir una capacidad común.
Esto permite hablar de una convergencia de diseño comercial, no de que OpenAI esté copiando exactamente todos los límites de Anthropic. Sus sistemas, planes, restablecimientos y condiciones son diferentes.
Pero el principio es semejante: el usuario conserva una suscripción, mientras el uso intensivo de determinados modelos y agentes se administra mediante límites visibles.
¿Hemos vivido una etapa de «barra libre»?
Como descripción de la experiencia de muchos usuarios, la expresión tiene algo de verdad. Las suscripciones de consumo han permitido experimentar con herramientas cada vez más capaces sin tener que consultar una factura por cada interacción.
Pero «prácticamente ilimitado» no significa «sin límites». Los topes por mensajes, modelos, sesiones y capacidad han existido durante años y han ido cambiando.
Podemos plantear, como hipótesis económica razonable, que una industria en expansión esté dispuesta a ofrecer condiciones de uso atractivas para impulsar la adopción, adquirir usuarios y competir por convertirse en la herramienta habitual. Sin embargo, no disponemos aquí de documentación pública suficiente para atribuir a todas las empresas una estrategia deliberada de subsidiar ilimitadamente cada tarea.
Hay una explicación de producto que sí está respaldada por los cambios actuales: el servicio que estamos comprando ya no se limita a generar texto. Ahora también puede programar, navegar por páginas, interactuar con aplicaciones, transformar archivos y ejecutar procesos de varios pasos. El coste de atender estos trabajos es más variable.
Por tanto, la evolución hacia presupuestos compartidos también es una respuesta a un producto distinto.
De la tarifa plana al consumo por capacidad: la analogía con la nube
Una suscripción de streaming suele asociarse a un precio fijo y a un catálogo disponible dentro de unas condiciones. La computación en la nube, en cambio, acostumbra a diferenciar recursos incluidos, capacidad contratada y consumo adicional.
La IA avanzada empieza a reunir elementos de ambos modelos:
| Elemento | Modelo que empieza a consolidarse |
|---|---|
| Suscripción | Da acceso al producto y a determinados usos incluidos. |
| Capacidad incluida | Permite utilizar modelos o agentes hasta unos límites definidos por el plan. |
| Consumo variable | Tareas distintas gastan cantidades diferentes de esa capacidad. |
| Ampliación de uso | Según el producto, permite esperar al restablecimiento, cambiar de plan o utilizar créditos elegibles. |
Esta tabla es una interpretación del modelo comercial, no una tarifa oficial ni una afirmación de que todos los servicios de IA vayan a adoptar exactamente el mismo sistema.
La analogía con el cloud computing es útil porque introduce una disciplina conocida en empresas tecnológicas: medir cuánto cuesta obtener un resultado, no solo cuánto cuesta tener acceso a una herramienta.
El efecto menos visible: elegir mejor los modelos
Si una tarea sencilla y una compleja consumen de forma distinta, seleccionar siempre el modelo más potente puede ser una decisión poco eficiente.
Una clasificación inicial podría ser:
Tareas sencillas. Reformular un correo, explicar un concepto cotidiano o resumir una nota breve. Un modelo rápido suele ser un punto de partida razonable, con revisión proporcional al riesgo.
Tareas de análisis. Comparar documentos, estudiar alternativas, revisar cifras o preparar recomendaciones. Aquí puede estar justificado utilizar un modelo avanzado y aportar contexto mejor preparado.
Trabajo agéntico. Investigar varias fuentes, operar sobre archivos, escribir software, ejecutar pruebas o coordinar herramientas. En estos casos la capacidad consumida puede aumentar rápidamente; conviene fijar objetivos, permisos, criterios de éxito y condiciones de parada.
Este enfoque no implica que los modelos pequeños sean siempre suficientes ni que un modelo potente resulte más caro por tarea terminada. Un sistema más capaz podría necesitar menos intentos. Lo correcto es comparar el coste total de conseguir un resultado fiable, incluyendo el tiempo de supervisión humana.
El riesgo de optimizar créditos y perder calidad
Una empresa podría intentar ahorrar utilizando siempre el modelo menos exigente. Pero si ese modelo comete errores, exige repetir el trabajo o genera decisiones incorrectas, el supuesto ahorro desaparece.
Hay que considerar al menos cuatro variables: consumo de IA, tiempo de preparación, revisión humana y coste de los errores.
Imaginemos un agente que ahorra una hora de trabajo manual, pero obliga después a invertir cuarenta minutos en revisar y corregir lo producido. La mejora real es muy distinta de la que sugeriría el tiempo de generación.
Por eso es importante aplicar el enfoque de mejorar el proceso antes de automatizarlo y recordar que el bucle agéntico necesita límites de ejecución, comprobaciones y supervisión. Una tarea que se repite sin criterio puede consumir capacidad sin acercarse a un resultado útil.
Qué deberían empezar a medir las pymes
Este cambio no exige instalar un complejo sistema de facturación de IA. Para la mayoría de empresas pequeñas, el primer paso es más sencillo: dejar de confundir número de consultas con valor generado.
Una prueba práctica podría consistir en elegir dos tareas recurrentes, por ejemplo preparar borradores de presupuestos y clasificar correos, y registrar durante unas semanas:
- Resultado: qué trabajo útil se ha completado.
- Tiempo humano: cuánto se ha invertido en preparar, revisar y corregir.
- Consumo: qué parte de la asignación o créditos se ha utilizado, cuando el producto permita consultarlo.
- Calidad: qué errores y retrabajos se han producido.
- Valor: qué ahorro, mejora o capacidad adicional ha generado el proceso.
No hace falta inventar un precio por token para realizar esta evaluación. Si las plataformas cambian sus límites, los datos sobre tiempo, calidad y valor seguirán siendo útiles.
La recomendación tampoco es delegar todas las tareas a agentes. En muchos casos bastará una plantilla, una integración convencional o una mejora del procedimiento existente.
Una tendencia que conviene seguir, no dar por cerrada
La noticia confirma la convergencia de varias experiencias de trabajo y la importancia creciente de los límites compartidos. También encaja con una transformación más amplia: los fabricantes quieren que sus asistentes pasen de responder preguntas a resolver encargos de principio a fin.
Lo que todavía no podemos afirmar es que las suscripciones de tarifa plana vayan a desaparecer, que todos los proveedores adopten un único precio por token, o que la mayoría de usuarios vaya a pagar más. Para eso harán falta datos sobre los límites efectivos, su evolución, el consumo de tareas reales y la respuesta de los clientes.
La transición anunciada es una señal clara. Las consecuencias económicas concretas todavía deben medirse.
En resumen
OpenAI ha anunciado una experiencia más unificada entre Chat y Work y una asignación de uso compartida con Codex para determinados planes desde diciembre de 2026. La complejidad de las tareas y el modelo utilizado influirán en cuánto se consume. Instant queda fuera del nuevo cupo, de modo que no estamos ante el final general del chat incluido en la suscripción.
Anthropic ya aplica límites comunes a varias experiencias de Claude, lo que permite identificar una tendencia: las empresas de IA empiezan a hacer más visible y gestionable la capacidad de trabajo que ofrecen, especialmente en tareas agénticas.
La oportunidad para profesionales y pymes es sencilla de formular, aunque exige disciplina para ejecutarla: utilizar la capacidad adecuada para cada trabajo, comprobar el resultado y medir su valor real.
Quizá la pregunta empresarial más importante deje de ser «¿cuántas veces puedo preguntarle algo a la IA?» y pase a ser «¿cuánto trabajo útil y fiable consigo con la capacidad que estoy pagando?».
Fuentes oficiales
- OpenAI — Understanding ChatGPT and Codex usage limits.
- OpenAI — ChatGPT Work y Codex.
- OpenAI — Gestionar el uso de GPT-6 Astra en Work y Codex.
- OpenAI — Usar Codex con tu plan de ChatGPT.
- Anthropic — Cómo funcionan los límites de uso y longitud.
- Anthropic — Usar Claude Code con los planes de Claude.
Nota editorial (2 de noviembre de 2026): el artículo analiza anuncios y documentación de producto disponibles en esta fecha. Los límites y condiciones pueden cambiar con el despliegue. La portada utiliza un indicador de consumo del 70 % únicamente a modo de ilustración; no representa el saldo ni la cuota real de ningún plan.