Gemini Decision 1: la IA que decide en lugar de redactar
Google presenta Gemini Decision 1 para clasificar, puntuar y elegir con probabilidades. Analizamos Jev, los agentes, las pruebas y sus límites para pymes.
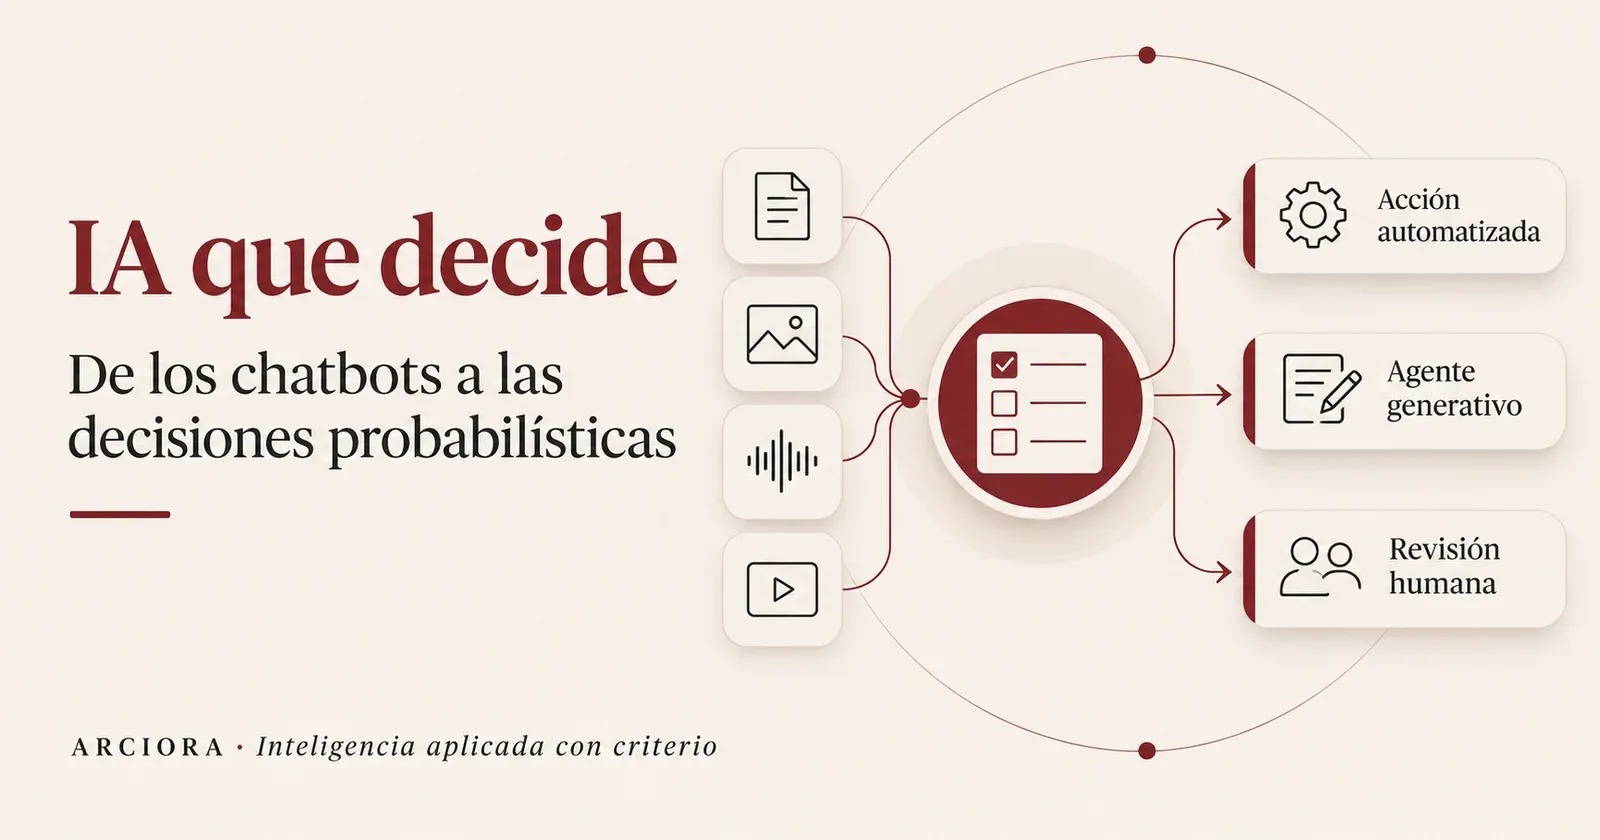
La mayoría de las herramientas de inteligencia artificial que conocemos están diseñadas para responder: escriben un correo, explican un concepto, resumen un informe o generan código. Pero en un proceso de empresa hay muchas ocasiones en las que no necesitamos otra respuesta de varios párrafos. Necesitamos algo mucho más concreto: elegir una opción, comprobar una condición o puntuar una situación.
¿Este correo requiere contestación o solo archivarlo? ¿Qué herramienta debería utilizar un agente? ¿Un documento contiene la información que necesitamos? ¿La petición debe pasar a una persona antes de ejecutarse?
Google acaba de presentar Gemini Decision 1, un modelo especializado en ese tipo de decisiones. Su lanzamiento, anunciado el 11 de noviembre de 2026, forma parte de una tendencia que merece atención: separar el trabajo de decidir del trabajo de generar contenido.
No es el primer modelo de esta clase. Antes ya existía Jev, de TypeSafe AI, junto con otros proyectos de decisión especializados. Lo relevante es que Google incorpora esa idea al ecosistema Gemini, con una API propia y soporte para texto, imágenes, audio, vídeo y PDF.
¿Qué es un modelo de decisión y en qué se diferencia de un chatbot?
Un chatbot convencional recibe instrucciones y produce una respuesta de texto. Aunque podamos pedirle que conteste solo «sí» o «no», el mecanismo habitual de un modelo generativo consiste en ir produciendo su salida paso a paso.
Un modelo de decisión está diseñado para un problema más acotado: recibe información, conoce las alternativas permitidas y devuelve una elección acompañada de puntuaciones o probabilidades. No pretende redactar un informe: pretende ayudar a un programa a decidir qué hacer a continuación.
Pensemos en un ejemplo cotidiano. Un pequeño negocio recibe una consulta de un cliente. La primera decisión podría ser seleccionar una de estas categorías:
- Consulta sobre un presupuesto.
- Solicitud de información general.
- Incidencia sobre un pedido.
- Mensaje que necesita revisión humana.
Un modelo generativo puede leer el mensaje y redactar una respuesta, pero para clasificarlo quizá no necesitemos toda su capacidad. Un modelo especializado puede devolver la categoría más probable para que otra parte del sistema continúe el trabajo.
Hay una condición imprescindible: el sistema solo puede elegir entre las opciones que le hemos definido. Si falta una categoría adecuada o las instrucciones son ambiguas, una respuesta muy segura puede seguir siendo equivocada.
Qué ofrece Gemini Decision 1
La presentación oficial de Google describe una API independiente, llamada Gemini Decisions API, cuyo primer modelo es `gemini-decision-1`.
Entre sus características anunciadas destacan:
| Capacidad | Qué significa en la práctica |
|---|---|
| Tres tipos de pregunta | Comprobar una condición (sí/no), elegir entre opciones o asignar una puntuación según una escala definida |
| Hasta 1.000 preguntas por petición | Evaluar muchas cuestiones independientes sobre una misma información |
| Contexto de hasta 256.000 tokens | Procesar una entrada extensa, por ejemplo documentación o una conversación larga, dentro de los límites admitidos |
| Entrada multimodal | Trabajar con texto, imágenes, audio, vídeo y PDF |
| Probabilidades de salida | Obtener puntuaciones para comparar alternativas y decidir cuándo escalar un caso |
Google indica que el modelo puntúa las opciones en una sola pasada, sin generar una respuesta palabra por palabra, y comunica latencias de extremo a extremo de 150 a 250 milisegundos para sus condiciones de prueba. La cifra no debe entenderse como una garantía universal: el tiempo real dependerá del tamaño de la entrada, el número de preguntas y la integración.
Algo especialmente práctico es que las distintas preguntas pueden compartir una misma entrada. Si enviamos una ficha de producto, por ejemplo, podemos comprobar varias condiciones sobre ella sin volver a proporcionar el documento completo para cada pregunta.
La función está orientada a desarrolladores y sistemas integrados mediante API. No es, de momento, un botón que cualquier usuario encontrará necesariamente en la aplicación de chat Gemini.
Las tres decisiones que puede devolver
Google distingue tres tipos de evaluación:
1. Sí o no (noul). Sirve para estimar si se cumple una condición concreta: «¿Este documento menciona una fecha de entrega?». El resultado incluye una probabilidad de que la condición sea cierta.
2. Elección entre alternativas (choice). Permite seleccionar una opción entre varias. Según Google, pueden definirse entre 2 y 255 opciones, con probabilidades normalizadas para las candidatas.
3. Puntuación con rúbrica (score). Evalúa un contenido usando niveles ordenados que el desarrollador define. Por ejemplo, clasificar la urgencia de una incidencia en baja, media o alta, además de ofrecer una puntuación continua.
Estos resultados son útiles para programar flujos, pero no sustituyen las reglas del negocio. Si una incidencia requiere obligatoriamente aprobación humana, la aplicación debe imponer esa obligación; no debería dejarla a la interpretación de una probabilidad.
Jev: la referencia anterior al anuncio de Google
Conviene reconocer de dónde viene esta idea. TypeSafe AI presentó en septiembre de 2026 Jev, un modelo pensado para devolver decisiones tipadas y puntuaciones de confianza en lugar de texto libre.
Su propuesta es parecida en lo esencial: una aplicación plantea preguntas delimitadas, el modelo devuelve respuestas estructuradas y el software decide qué pasos ejecutar a partir de ellas.
En la documentación y presentación de TypeSafe AI, la empresa describe esta arquitectura como una forma de construir sistemas de automatización que distingan entre actuar, pedir más información o solicitar intervención humana.
Después aparecieron otros modelos especializados, como Nimble, de Bespoke Labs, y Tev1, de Together AI. No son idénticos ni comparten necesariamente arquitectura, modalidades o prestaciones, pero pertenecen a la misma corriente: modelos optimizados para decidir sobre opciones acotadas.
Por tanto, Gemini Decision 1 no inaugura la categoría. Lo que aporta es escala de producto, integración con el ecosistema Gemini y un soporte multimodal anunciado desde su lanzamiento.
¿Es mejor que Jev? Los resultados requieren contexto
Google publica una comparativa con otros modelos de decisión. En el conjunto de siete pruebas directamente compartidas con Jev 1.14, GPT-6 Luna (Decisions) y Gemini 3.5 Flash-Lite, Gemini Decision 1 obtiene la mejor puntuación en cinco. Jev lidera las otras dos, relacionadas con tareas de navegación y decisiones sobre uso de herramientas.
Por ejemplo, la tabla de Google señala:
| Evaluación | Gemini Decision 1 | Jev 1.14 | Qué conviene interpretar |
|---|---|---|---|
| JevBench (partición pública) | 92,2 % | 90,0 % | Google obtiene mejor resultado en esa partición |
| Mind2Web Multimodal | 86,2 % | 86,8 % | Jev supera ligeramente a Gemini |
| When2Call | 79,9 % | 82,0 % | Jev obtiene un resultado mejor en decisiones de llamada a herramientas |
| Error de calibración (ECE) | 0,0250 | 0,0494 | En el conjunto evaluado por Google, Gemini muestra menor error |
Además, Google incluye dos evaluaciones de audio y vídeo comparadas con Flash-Lite, pero sin resultados equivalentes de Jev y GPT-6 Luna. Por eso no sería correcto afirmar sin matices que Google ha ganado siete de nueve pruebas frente a todos sus competidores.
También hay que distinguir la evaluación del fabricante de otras mediciones. Una prueba externa publicada el 12 de noviembre por TrueStandard, basada en 108 afirmaciones contrastadas con fuentes en cuatro idiomas, obtuvo un comportamiento de calibración diferente. En ese experimento limitado, Jev mostró menor error de calibración en inglés y español. No invalida los resultados de Google —las tareas y metodologías son distintas—, pero ilustra por qué no debemos trasladar directamente un benchmark a un proceso empresarial.
Por qué importa que las probabilidades estén calibradas
Que un modelo responda con un «90 % de confianza» resulta atractivo para automatizar procesos, pero ese número solo es útil si se corresponde razonablemente con lo que ocurre en la práctica.
Un modelo está bien calibrado cuando, al agrupar muchas decisiones a las que asigna una probabilidad similar, la frecuencia de aciertos se aproxima a esa probabilidad. Si de cien decisiones marcadas con una confianza del 80 % aproximadamente ochenta resultan correctas, existe una señal de buena calibración en ese conjunto.
El ECE (Expected Calibration Error) resume la diferencia entre confianza y resultados observados. Un valor menor suele ser mejor, pero depende de cómo se construya la prueba, la distribución de los datos y el cálculo empleado.
Eso abre una posibilidad útil: establecer umbrales para que ciertas decisiones sigan un camino automático y otras se revisen. Un 95 % declarado por el modelo, sin embargo, no demuestra que alcance un 95 % real de fiabilidad en nuestra empresa.
Antes de utilizar esa cifra para automatizar, tendríamos que comprobarla con casos representativos del proceso concreto. Y en decisiones de seguridad, financieras, laborales o que afecten a personas, la revisión humana y las reglas deterministas pueden seguir siendo necesarias incluso con puntuaciones elevadas.
La combinación más interesante: decidir con un modelo y redactar con otro
El verdadero valor aparece cuando combinamos distintas capacidades.
Imaginemos un agente que gestiona consultas entrantes de una pyme. Podríamos organizarlo así:
- Reglas del negocio: comprobar requisitos formales, permisos y bloqueos obligatorios. Las condiciones estrictas deben resolverse mediante reglas explícitas cuando sea posible.
- Modelo de decisión: clasificar el mensaje, detectar si falta información o seleccionar una herramienta disponible.
- Enrutamiento según confianza: enviar los casos claros a un flujo preparado y los ambiguos a revisión humana.
- Modelo generativo: redactar un borrador únicamente cuando sea necesario explicar algo al cliente o elaborar un documento.
- Revisión y trazabilidad: comprobar los datos utilizados y conservar el historial de decisiones relevantes.
Así, no encargamos a un modelo generativo completo cada pequeña bifurcación del proceso. Reservamos la generación para donde realmente aporta valor: explicar, escribir, sintetizar o construir una respuesta.
Este planteamiento se relaciona con el bucle agéntico y con una idea que ya hemos trabajado en ARCIORA: antes de automatizar, hay que revisar si el proceso merece existir.
Qué ventajas puede tener para profesionales y pymes
El interés práctico está en crear automatizaciones más comprensibles y controlables. Hay varios escenarios que merece la pena explorar:
Clasificación de solicitudes. Identificar el tipo de correo recibido y proponer el departamento o flujo al que debería dirigirse, sin generar una explicación innecesaria.
Comprobación documental. Analizar un PDF o una ficha técnica y estimar si contiene determinados apartados. La verificación final debe contrastar el dato con la fuente.
Selección de herramientas. Dentro de un agente, elegir si corresponde consultar un CRM, buscar en la documentación o solicitar intervención humana.
Control de calidad de respuestas. Revisar si un borrador cumple criterios definidos antes de entregarlo a una persona responsable.
Evaluación de imágenes o vídeos. Clasificar situaciones visuales delimitadas. Esto no autoriza a utilizar el modelo como sustituto de sistemas de seguridad industrial certificados.
Estos son ejemplos de posibles aplicaciones, no implantaciones realizadas por ARCIORA ni ahorros demostrados. Tampoco todos necesitan IA. Si el mismo resultado se obtiene de forma fiable con una regla sencilla, utilizar un modelo añadiría complejidad sin aportar valor.
Qué sucede con el consumo y los costes
Google presenta Gemini Decision 1 como un servicio de baja latencia y consumo adaptado a decisiones acotadas. La API factura la información de entrada y no añade cargos por tokens generados; además, Google anuncia un nivel de prueba para prototipos en AI Studio.
El coste real de un sistema no depende solamente del precio nominal del modelo. También cuentan el número de llamadas, la longitud de los documentos, los controles, los reintentos, las integraciones y la supervisión.
No deberíamos concluir que cualquier decisión con este modelo resultará más económica que una clasificación convencional o que Jev. La comparación correcta es el coste de completar una tarea correctamente, no solo el coste teórico de una petición.
Y si se utilizan datos de clientes o documentos empresariales, también deben revisarse las condiciones aplicables de uso, tratamiento de datos y acceso a la API, especialmente al probar niveles gratuitos.
Cómo probar esta tecnología sin complicar el negocio
Para una pyme, no empezaría sustituyendo todo el sistema de atención al cliente o el motor de procesos. Prepararía un piloto pequeño, medible y reversible.
Por ejemplo, tomaríamos 50 a 100 consultas históricas anonimizadas y definiríamos de antemano la categoría correcta de cada una. Después probaríamos un modelo de decisión y compararíamos sus resultados con un procedimiento existente.
Mediríamos cuatro cosas:
- Exactitud: cuántos casos clasifica correctamente y cuáles son los errores más importantes.
- Calibración: si las puntuaciones de confianza representan de forma razonable los aciertos reales.
- Intervención humana: cuántos casos necesitan revisión y por qué.
- Esfuerzo total: tiempo de preparación, supervisión, mantenimiento e integración.
También incluiríamos mensajes ambiguos, documentos incompletos y casos que nunca deban ejecutarse automáticamente. Si el piloto no mejora el proceso, no habría motivo para desplegarlo.
La consultoría y las soluciones de IA aplicada deberían empezar precisamente por esa pregunta: qué problema existe, cómo se resuelve hoy y qué mejora verificable justificaría incorporar esta tecnología. Para ampliar conceptos, puede consultarse nuestro glosario sobre agentes de IA.
En resumen
Gemini Decision 1 representa un avance interesante, pero no porque Google haya creado una IA que «piensa mejor que las personas». Lo relevante es su especialización: responder preguntas cerradas, seleccionar alternativas y entregar probabilidades que permitan organizar el siguiente paso de un sistema.
Jev, de TypeSafe AI, ya había impulsado públicamente esta categoría, y el lanzamiento de Google demuestra que la especialización de los modelos está entrando en el centro de las plataformas de IA.
Hay ventajas potenciales en velocidad, integración y control, pero las cifras de calibración deben validarse con datos propios. Un modelo probabilístico no reemplaza reglas obligatorias ni la responsabilidad humana.
La dirección que apunta esta tecnología es clara: no todos los pasos de un agente necesitan un gran modelo generativo. Algunos solo requieren decidir bien entre opciones definidas. Y aprender a distinguir esas tareas puede ser tan importante como elegir el modelo más potente.
Fuentes y contexto
Fuentes consultadas el 12 de noviembre de 2026. Las prestaciones y condiciones de las API pueden cambiar.
- Google — Gemini Decisions API: Fast, calibrated multimodal decisions (11/11/2026). Anuncio, funcionamiento, benchmarks y disponibilidad.
- TypeSafe AI — System One Models y Jev. Explicación del modelo de decisiones tipadas y su orientación a automatización.
- Decision Models — cronología de Jev y los modelos de decisión. Referencia complementaria para situar lanzamientos anteriores.
- TrueStandard — Comparación independiente de Gemini Decision 1 y Jev 1.14 (12/11/2026). Evaluación exploratoria con alcance limitado y resultados por idioma.
- Google AI for Developers — API y resultados estructurados. Contexto técnico sobre el uso de salidas estructuradas.