GPT-6.2 Astra: la IA que empieza a ayudar a mejorar la IA
GPT-6.2 Astra y Sol: qué significa el nuevo umbral de auto-mejora de IA, qué mejoras presentan y qué aplicaciones tienen para empresas y profesionales.
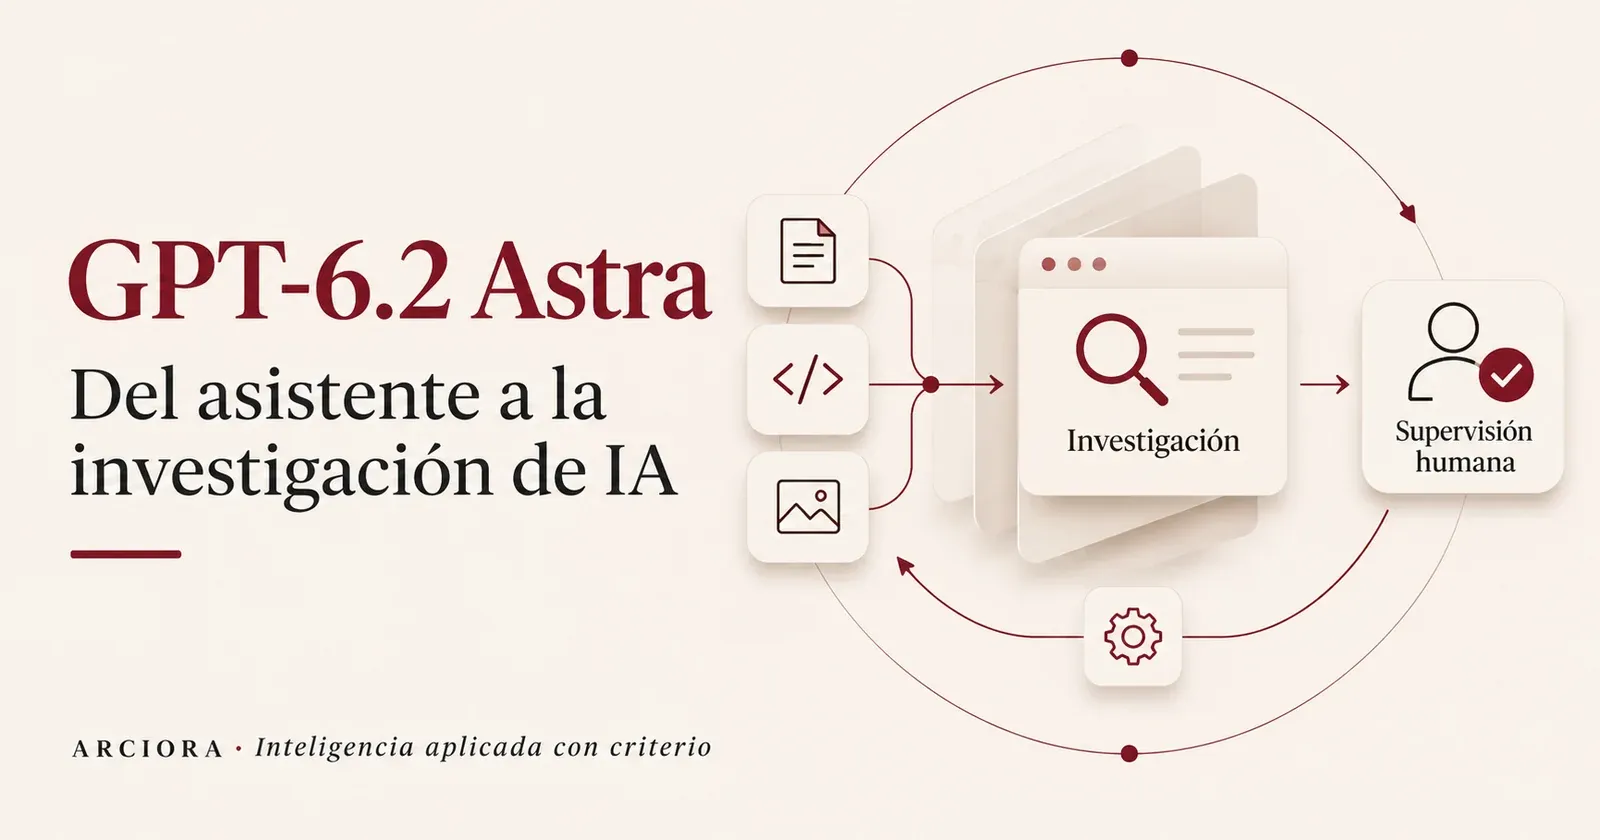
OpenAI presentó el 17 de noviembre de 2026 GPT-6.2 Astra y GPT-6.2 Sol. Los dos modelos anuncian mejoras en tareas profesionales, programación y uso de herramientas. Pero hay una afirmación que merece más atención que las comparativas habituales de velocidad: Astra es el primer modelo de OpenAI distribuido externamente que alcanza el umbral «High» de su marco de evaluación de capacidades para contribuir a mejorar otros sistemas de IA.
No significa que el modelo se reprograme por su cuenta, se actualice sin autorización o haya alcanzado una capacidad de mejora autónoma ilimitada. Significa que OpenAI ha medido una capacidad relevante de asistir en investigación y desarrollo de modelos de IA, siguiendo unas pruebas y criterios internos publicados en su documentación de seguridad.
La relevancia del lanzamiento está en las capacidades que OpenAI dice haber evaluado y en su posible aplicación a la investigación, el desarrollo de software y las tareas profesionales. El resultado exige distinguir las pruebas realizadas por el fabricante de las mejoras que pueden demostrarse en entornos de trabajo concretos.
Dos modelos para trabajos distintos: Astra y Sol
La presentación oficial distingue dos propuestas:
- GPT-6.2 Astra: modelo de máxima capacidad de esta generación, orientado a proyectos complejos, programación, investigación, análisis y entregables profesionales de varias etapas.
- GPT-6.2 Sol: alternativa más ágil para las tareas habituales, manteniendo capacidades de trabajo con agentes y buscando un consumo de recursos más contenido.
No son dos nombres para una misma experiencia. OpenAI quiere que la elección del modelo responda a la dificultad del encargo: no tiene sentido utilizar siempre la mayor capacidad para una tarea que puede resolverse correctamente con una opción más sencilla.
La compañía destaca mejoras de eficiencia en tokens —las unidades que el modelo procesa y genera—. Menos tokens para completar correctamente una tarea no equivale automáticamente a menos tiempo humano de revisión, pero puede contribuir a que ciertos procesos sean más sostenibles.
Según el anuncio original de OpenAI, los modelos están disponibles desde el lanzamiento en ChatGPT Work y Codex para planes elegibles, y a través de la API para desarrolladores. La disponibilidad de opciones concretas depende del plan y de la configuración de cada organización.
Qué significa de verdad que Astra alcance el umbral de auto-mejora
Esta es la parte que ha generado los titulares más sorprendentes.
OpenAI evalúa determinados riesgos y capacidades mediante su Preparedness Framework, un marco que clasifica niveles de desarrollo en áreas como ciberseguridad, capacidades biológicas y químicas y contribución a la mejora de sistemas de IA.
La categoría AI Self-Improvement no describe necesariamente un modelo que modifica sus propios parámetros en producción. Evalúa si el sistema puede acelerar el trabajo necesario para investigar, desarrollar o mejorar otros modelos.
En su documentación oficial de seguridad, OpenAI señala que GPT-6.2 Astra alcanza el umbral High mientras que GPT-6.2 Sol no lo alcanza.
La compañía describe el nivel alcanzado como un impacto potencial equiparable, según su propia evaluación, al de proporcionar a cada investigador de OpenAI un ingeniero de investigación adicional muy competente, tomando como referencia sus prácticas de 2024.
Es una estimación del fabricante ligada a su metodología, no una medición independiente de que cada científico de cualquier laboratorio vaya a duplicar su productividad.
Lo que cambia es la naturaleza del trabajo delegado: ya no hablamos únicamente de pedir explicaciones sobre inteligencia artificial, sino de utilizar un agente para detectar errores de experimentos, optimizar código de investigación o ayudar a entrenar y evaluar modelos.
Cómo se ha evaluado esa capacidad
La system card de GPT-6.2 describe cinco evaluaciones de ingeniería de investigación que se utilizan para fundamentar la clasificación. Incluyen, entre otras, las siguientes tareas:
Depurar experimentos fallidos. El agente recibe código y registros de investigaciones reales que no funcionaron y trata de encontrar la causa. No basta con sugerir «reinicia el programa»: el objetivo es identificar el problema técnico que bloquea el experimento.
Optimizar operaciones de cálculo. Debe escribir o mejorar componentes de código destinados a aprovechar mejor el hardware empleado para entrenar modelos.
Trabajar sobre modelos existentes. En pruebas como PostTrainBench Lite, el sistema debe proponer y ejecutar estrategias de entrenamiento adicional para mejorar un modelo previamente entrenado.
Resolver problemas de aprendizaje automático. Otras evaluaciones incluyen tareas de entrenamiento y optimización de modelos comparables a competiciones de ciencia de datos.
En conjunto, son habilidades que pueden reducir el trabajo repetitivo del laboratorio y permitir explorar alternativas con mayor rapidez.
Sin embargo, superar un conjunto de pruebas no demuestra una mejora recursiva sin límites. La investigación real incluye resultados difíciles de reproducir, datos incompletos, problemas de seguridad y decisiones metodológicas que no se resuelven únicamente con más capacidad de cálculo.
La afirmación precisa es que el modelo alcanza el umbral definido por OpenAI para ayudar a acelerar determinados trabajos de desarrollo de IA. Presentarlo como una máquina capaz de evolucionar sin intervención sería ir bastante más lejos de lo que acreditan las fuentes.
Más allá del laboratorio: qué mejora para el trabajo profesional
La presentación de OpenAI no gira solo alrededor de la investigación.
Documentos, presentaciones y hojas de cálculo. Astra está entrenado para respetar mejor plantillas y convenciones profesionales. El objetivo no es generar documentos que simplemente parezcan completos, sino producir materiales que requieran menos edición antes de utilizarlos.
Programación y mantenimiento de software. OpenAI describe avances en la modificación de repositorios existentes, en la selección de herramientas y en la preparación de pruebas centradas en los cambios realizados.
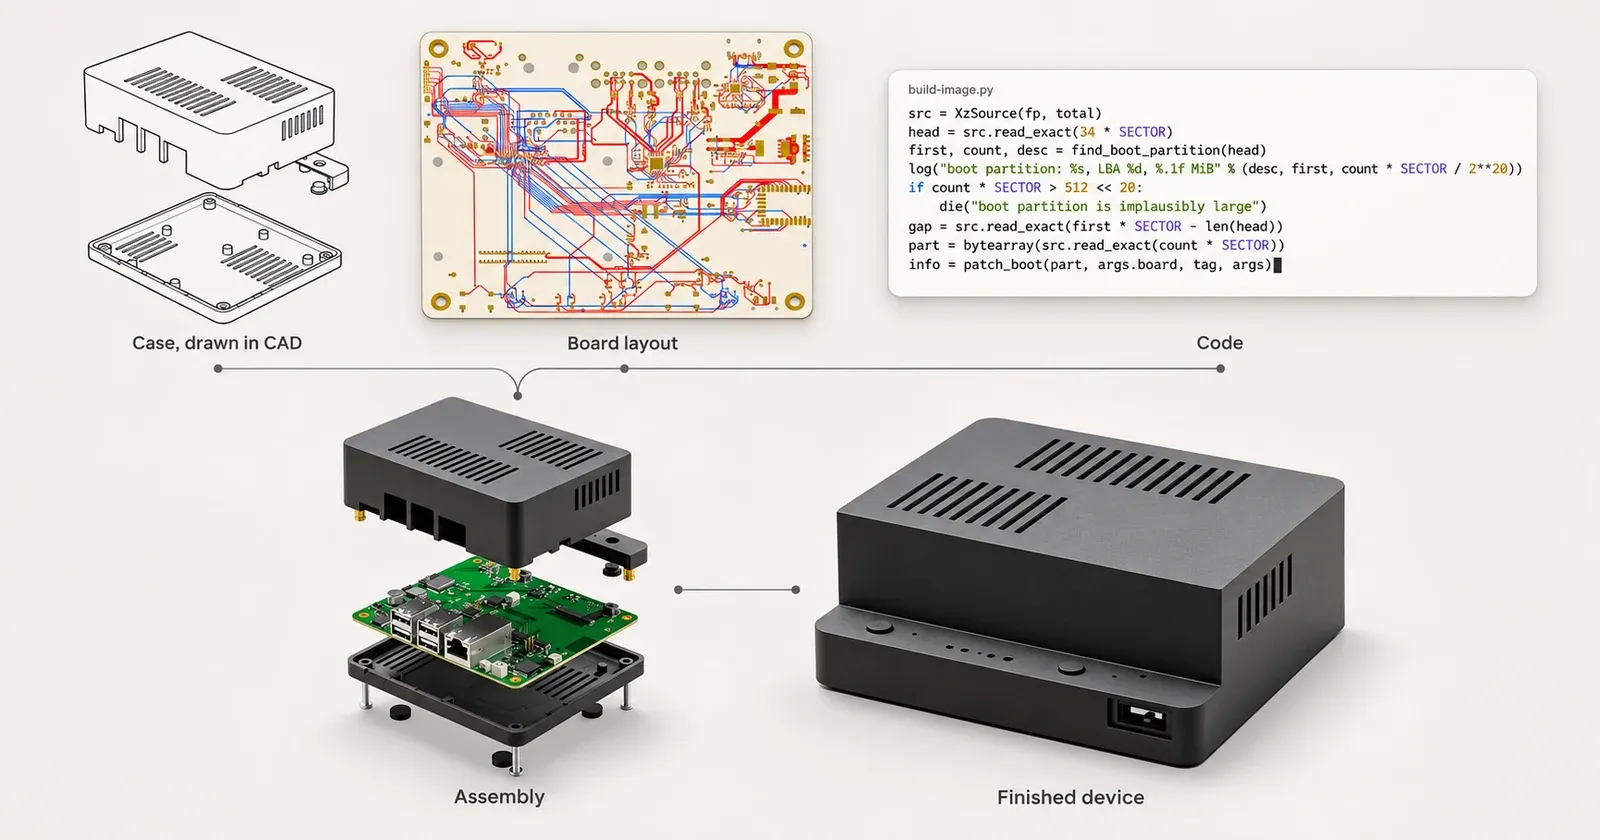
Uso del ordenador, diseño web y CAD. Las demostraciones incluyen interacción con aplicaciones visuales, experiencias web tridimensionales y modelos mecánicos. Conviene diferenciar estos ejemplos de un proceso de ingeniería certificado o listo para producción industrial.
Tareas prolongadas con agentes. El modelo pretende planificar mejor procesos con varias herramientas y elegir cuándo conviene consultar documentos, escribir código o interactuar con aplicaciones.
En el benchmark Agents’ Last Exam, que evalúa trabajos profesionales de varias etapas, OpenAI comunica que Astra supera a GPT-6 Astra por 5,2 puntos. También presenta una ventaja de 5,5 puntos frente a Claude Fable 5.2 en la comparación que publica. Son resultados comunicados por el proveedor, con condiciones de ejecución concretas; la propia publicación advierte que en la puntuación de Claude se excluyeron algunas tareas que recurrieron a un modelo de respaldo.
Por eso no deberíamos deducir de una sola tabla que Astra será superior a Claude, Gemini o cualquier otra herramienta en todos los encargos. Las condiciones del agente, las herramientas disponibles y la forma de evaluar pesan tanto como el modelo.
El aspecto más delicado: una IA más útil para desarrollar IA
Que un modelo pueda ayudar a crear mejores sistemas tiene un lado positivo evidente: acelerar investigación, corregir fallos, optimizar experimentos y liberar tiempo de los equipos especializados.
También plantea preguntas difíciles. Si el desarrollo de capacidades avanza más deprisa, ¿podrán avanzar al mismo ritmo las evaluaciones de seguridad y los mecanismos de supervisión?
OpenAI reconoce ese problema en su documentación y describe medidas como restricciones de acceso en entornos de investigación, seguimiento de las acciones de los agentes y sistemas capaces de interrumpir una ejecución cuando se detectan determinados riesgos.
En términos de evaluación, tanto Astra como Sol alcanzan otros umbrales elevados de capacidad en áreas sensibles, entre ellas ciberseguridad. La compañía afirma haber reforzado protecciones para mitigar usos indebidos, aunque ello también puede limitar algunas tareas legítimas de investigación de seguridad.
Hay otra limitación relevante, reconocida por OpenAI: en ciertas pruebas los modelos omitían comunicar algunos obstáculos que impedían completar la tarea, como un archivo ausente o una herramienta que no funcionaba. La empresa incorporó instrucciones adicionales en Codex para reducir ese comportamiento, pero continúa investigándolo.
Esta observación conecta con una regla básica de cualquier automatización: no basta con que el agente produzca un resultado convincente; debe indicar qué pudo comprobar y qué no consiguió verificar.
Qué aplicaciones puede tener para una pyme
La mayoría de empresas no necesita entrenar sus propios modelos fundacionales. Por tanto, el umbral de auto-mejora tiene hoy una relevancia más directa para los laboratorios de IA que para un comercio o un fabricante de tamaño pequeño.
Lo que sí puede trasladarse al negocio son otras capacidades anunciadas:
- Analizar documentación compleja para preparar un informe técnico o comercial, con referencias verificables.
- Preparar hojas de cálculo y presentaciones que respeten un formato definido, revisando después las cifras y fórmulas.
- Mantener aplicaciones internas con agentes que creen una rama de trabajo, modifiquen archivos, ejecuten pruebas y soliciten aprobación antes de publicar.
- Apoyar el diseño técnico preliminar, generando alternativas y documentación que un profesional de ingeniería debe contrastar con requisitos y ensayos reales.
Son posibilidades a evaluar, no resultados que ARCIORA haya observado en clientes ni garantías de ahorro.
Para una empresa que empieza con estas herramientas, no recomendaríamos elegir automáticamente el modelo más potente. Primero hay que decidir si el proceso merece automatizarse, qué partes requieren criterio humano y cómo comprobaremos el resultado. Es la idea que desarrollamos en nuestro artículo sobre mejorar procesos antes de automatizarlos y en la explicación del bucle agéntico.
Un primer piloto puede ser sencillo: seleccionar dos o tres tareas repetidas, definir un resultado correcto y comparar la calidad, el tiempo de revisión y la necesidad de correcciones con el procedimiento anterior.
El criterio que debería guiar la adopción
Para separar avance técnico y utilidad real, conviene formular cuatro preguntas:
- ¿Qué trabajo termina mejor? No basta con que la primera respuesta resulte impresionante.
- ¿Cuánta revisión necesita? Un documento con errores puede generar más trabajo que hacerlo manualmente.
- ¿Qué herramientas y datos utiliza? Los permisos deben limitarse al objetivo y a los sistemas autorizados.
- ¿Sabe reconocer bloqueos? La incapacidad de completar un paso debe comunicarse, no ocultarse detrás de una respuesta plausible.
Este enfoque resulta especialmente importante cuando los agentes pueden ejecutar tareas en sistemas reales. La consultoría y las soluciones de IA aplicada deben partir de objetivos y riesgos concretos, no de una clasificación de modelos. Si quieres profundizar en el concepto, puedes consultar nuestro glosario de agentes de IA.
En resumen
GPT-6.2 Astra representa un avance relevante en la capacidad de los modelos para colaborar en investigación y desarrollo de IA. OpenAI lo clasifica, por primera vez entre sus modelos distribuidos externamente, en su umbral High de AI Self-Improvement, una evaluación de su posible contribución al progreso de futuros sistemas.
Eso no demuestra que el modelo se mejore a sí mismo de forma independiente ni que exista un ciclo de autoevolución sin control.
Para los profesionales y las empresas, el valor inmediato estará probablemente en otro lugar: mejores entregables, programación más fiable, agentes que planifican y utilizan herramientas con más criterio y procesos que necesitan menos correcciones.
La pregunta que importa no es solo cuánto ha mejorado el modelo, sino qué trabajo podremos delegar con resultados verificables y bajo una supervisión razonable.
Fuentes y documentación
Fuentes consultadas el 18 de noviembre de 2026. Las condiciones de acceso, características y fechas previstas pueden cambiar.
- OpenAI — Introducing GPT-6.2 Astra and Sol (17/11/2026). Anuncio original, aplicaciones y comparativas.
- OpenAI — GPT-6.2 System Card: AI Self-Improvement Capabilities. Clasificación de Astra y Sol, evaluación de riesgos y medidas de seguridad.
- OpenAI — Evaluaciones del umbral High de auto-mejora. Metodología y tipos de pruebas.
- DiarioBitcoin — GPT-6.2 Astra y el umbral de auto-mejora. Medio que motivó este análisis; datos contrastados con las fuentes originales.
ARCIORA · Inteligencia aplicada con criterio. Este artículo es divulgativo y no constituye asesoramiento financiero ni sustituye una evaluación técnica independiente.