Transformer: por qué «Attention Is All You Need» cambió la IA
Qué hizo diferente al Transformer de 2017, cómo funciona la autoatención y por qué esta arquitectura está detrás de buena parte de la IA generativa actual.
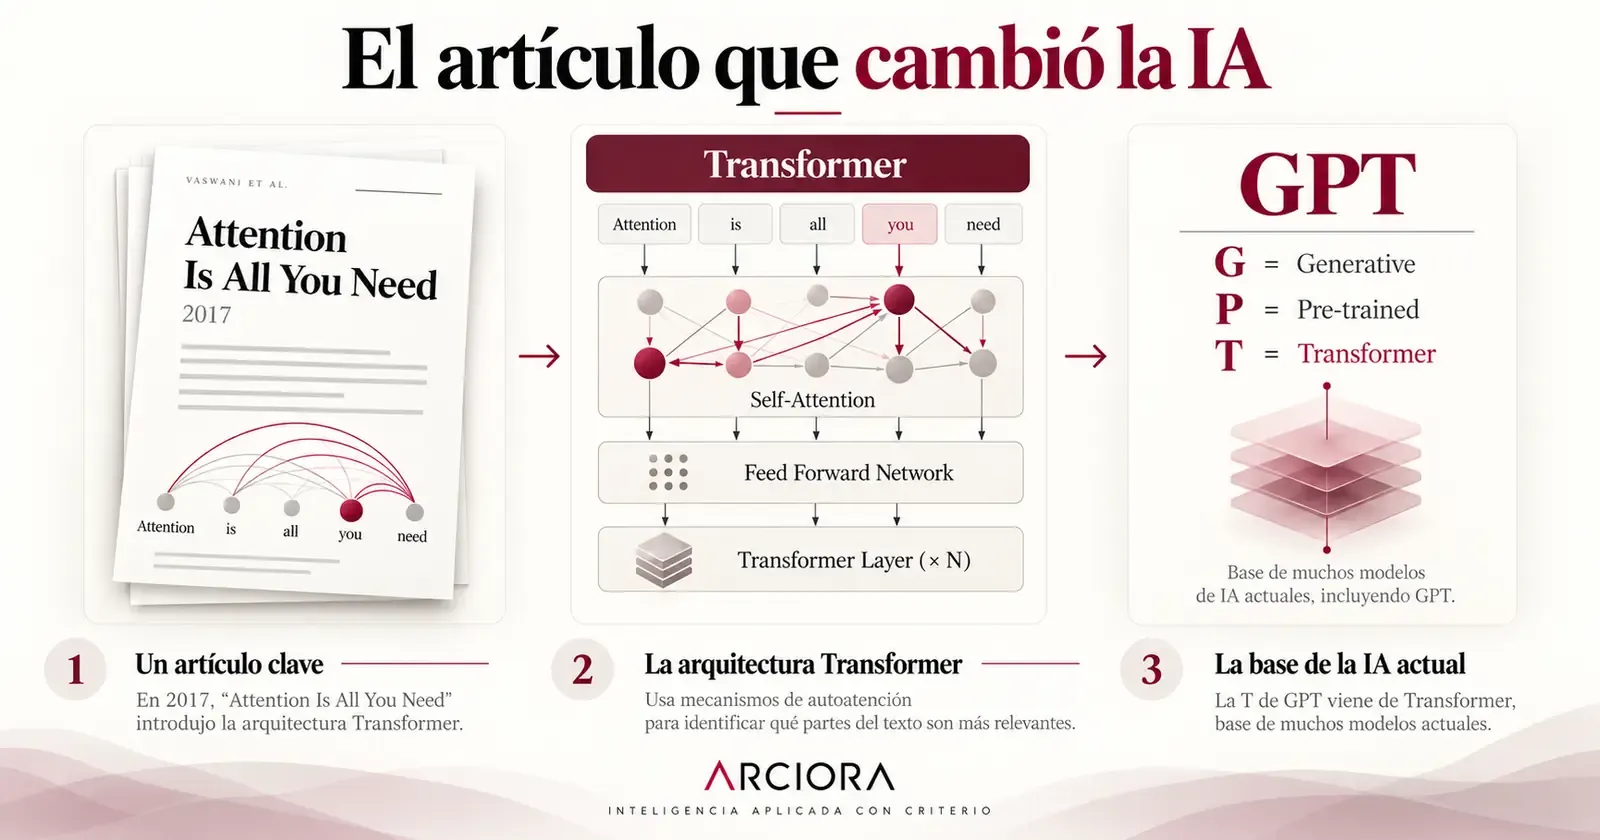
En 2017 se publicó un artículo con un título poco habitual para un trabajo académico: “Attention Is All You Need”.
Sus ocho autores —Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N. Gomez, Łukasz Kaiser e Illia Polosukhin— presentaron una arquitectura nueva a la que llamaron Transformer.
Hoy ese nombre aparece detrás de buena parte de los modelos de lenguaje modernos. Pero el valor del trabajo no está en una frase de marketing ni en una única técnica aislada. Está en que propuso una forma distinta de procesar secuencias que resultaba más paralelizable, más eficiente de entrenar y muy eficaz para capturar relaciones entre elementos alejados.
Entender por qué fue importante ayuda también a entender mejor qué hay detrás de los sistemas de IA que utilizamos hoy.
Antes del Transformer: el problema de procesar secuencias
El lenguaje tiene una dificultad básica: el significado de una palabra depende de las demás.
En una frase como:
“Llegué al banco después de cruzar el río.”
la palabra banco podría referirse a una entidad financiera o a la orilla de un río. La palabra río, aunque aparezca más adelante, cambia por completo la interpretación correcta.
Antes del Transformer, buena parte de los sistemas de procesamiento del lenguaje utilizaban redes recurrentes —RNN, LSTM o GRU— que procesaban la información de manera fundamentalmente secuencial.
Simplificando mucho: una palabra se procesaba después de otra y cada paso dependía del anterior.
Este enfoque funcionaba, pero tenía dos limitaciones importantes.
La primera era computacional: esa dependencia entre pasos dificultaba procesar muchas posiciones de una secuencia en paralelo.
La segunda estaba relacionada con el contexto: aunque arquitecturas como LSTM mejoraban el manejo de dependencias largas, relacionar información muy alejada dentro de una secuencia seguía siendo un problema difícil.
El artículo de 2017 propuso otro camino.
La idea clave: construir el modelo alrededor de la atención
La atención no nació con el Transformer. Ya se utilizaba anteriormente en modelos de traducción y otras tareas.
Lo novedoso fue llevar la idea mucho más lejos.
Los autores propusieron una arquitectura que prescindía de las redes recurrentes y de las convoluciones como mecanismo principal para modelar la secuencia. En su lugar, el Transformer se apoyaba en mecanismos de atención.
El propio resumen del trabajo lo expresa con claridad: una arquitectura basada únicamente en atención, sin recurrencia ni convoluciones, capaz de obtener mejores resultados en sus tareas de traducción y de entrenarse de forma mucho más paralela.
Google Research — Attention Is All You Need
Qué es la autoatención, explicado sin fórmulas
Uno de los conceptos fundamentales del Transformer es la self-attention, o autoatención.
La idea puede resumirse así:
para representar cada palabra, el modelo mira también a las demás palabras de la secuencia y calcula cuánto debería importar cada una en ese contexto.
Volvamos al ejemplo:
“Llegué al banco después de cruzar el río.”
Cuando el modelo procesa banco, puede asignar más importancia a río que a otras palabras. Esa relación ayuda a construir una representación de banco más adecuada al contexto.
No se trata de que el sistema consulte un diccionario y elija una definición. Lo que hace es construir representaciones numéricas en las que las relaciones entre elementos de la secuencia influyen unas sobre otras.
Google utilizó precisamente un ejemplo parecido al explicar la arquitectura en 2017: la autoatención permite comparar una palabra con las demás y asignar puntuaciones que determinan cuánto contribuye cada una a su nueva representación.
Google Research — explicación del Transformer
Query, Key y Value: una intuición útil
En una implementación de atención aparecen tres conceptos que suelen representarse como:
- Query
- Key
- Value
No hace falta entrar en las ecuaciones para entender la intuición.
Podemos imaginar que, para cada elemento, el modelo genera:
- una representación de qué está buscando (query);
- una representación de qué información ofrece (key);
- y el contenido que puede aportar (value).
El sistema compara queries y keys para calcular qué elementos son más relevantes entre sí. Después combina los values utilizando esos pesos de atención.
No es una analogía perfecta, pero sirve para entender la lógica: cada elemento puede decidir dinámicamente qué otros elementos necesita tener más en cuenta.
Multi-head attention: mirar la misma secuencia de varias maneras
El Transformer no utiliza una única atención.
Utiliza multi-head attention, o atención multicabeza.
La idea es que diferentes cabezas de atención pueden aprender a fijarse en distintos tipos de relaciones.
Una podría prestar atención a dependencias sintácticas. Otra, a relaciones semánticas. Otra, a referencias entre palabras alejadas.
No existe una regla rígida que asigne una función concreta a cada cabeza, pero la arquitectura permite que el modelo represente simultáneamente diferentes relaciones dentro de la secuencia.
Esta capacidad fue una de las piezas que ayudaron al Transformer a capturar estructuras complejas sin depender de un procesamiento estrictamente paso a paso.
El gran cambio práctico: paralelización
Este punto es menos vistoso que la autoatención, pero fue decisivo.
Las redes recurrentes tenían una limitación estructural: para calcular un paso era necesario disponer del resultado del anterior.
Eso restringía la paralelización durante el entrenamiento.
El Transformer podía procesar muchas posiciones de una secuencia simultáneamente.
El propio artículo destaca que esta arquitectura era significativamente más paralelizable y necesitaba menos tiempo de entrenamiento en los experimentos de traducción presentados.
Esto encajó especialmente bien con el uso de GPU y, más adelante, con infraestructuras de cálculo cada vez mayores.
El resultado fue una combinación muy potente:
arquitectura escalable + grandes volúmenes de datos + más capacidad de cálculo.
Esa combinación explica buena parte de la evolución posterior de los modelos de lenguaje.
Si todo se procesa en paralelo, ¿cómo sabe el modelo el orden?
Aquí aparece otro problema interesante.
Si una red recurrente procesa una frase palabra por palabra, el orden está incorporado de forma natural en el proceso.
Pero si el Transformer puede procesar distintas posiciones en paralelo, necesita otra forma de saber si una palabra aparece antes o después.
Por eso la arquitectura original incorporó positional encoding, o codificación posicional.
Esta información se añade a las representaciones de entrada para que el modelo pueda distinguir la posición relativa o absoluta de los elementos de una secuencia.
Es un buen ejemplo de cómo una ventaja arquitectónica crea también un problema nuevo que debe resolverse explícitamente.
El Transformer original no era ChatGPT
Conviene separar dos cosas.
El Transformer de 2017 se presentó principalmente como una arquitectura para traducción automática y tareas de procesamiento de secuencias.
No era un chatbot generalista.
No era ChatGPT.
No era tampoco un modelo de lenguaje gigante como los actuales.
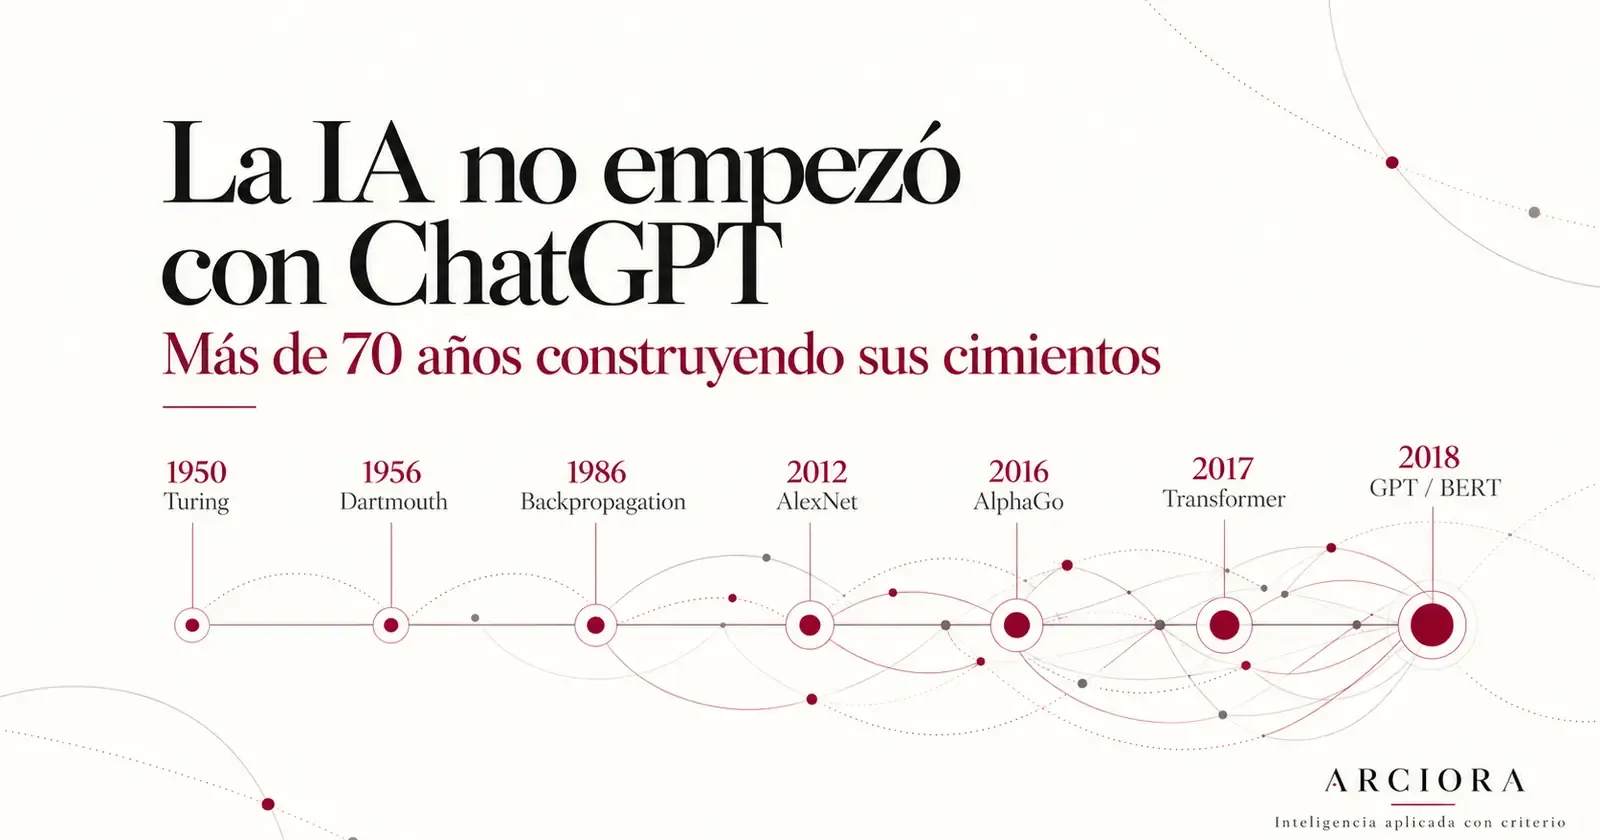
El salto posterior llegó cuando distintos equipos empezaron a utilizar y adaptar esa arquitectura para entrenar modelos sobre cantidades cada vez mayores de texto.
Ahí aparecen familias como BERT, T5 y GPT, entre muchas otras.
El Transformer fue una base arquitectónica. Los sistemas actuales son el resultado de esa base combinada con muchos otros avances.
¿Qué significa realmente GPT?
Una curiosidad útil para entender la relación entre estas tecnologías es el propio nombre GPT:
- G — Generative
- P — Pre-trained
- T — Transformer
En 2018, OpenAI publicó Improving Language Understanding by Generative Pre-Training, donde utilizó una arquitectura Transformer y un enfoque de preentrenamiento generativo seguido de ajuste para tareas específicas.
La idea del preentrenamiento resultó especialmente importante: en lugar de entrenar un modelo desde cero para cada tarea, se podía entrenar primero sobre grandes cantidades de texto y aprovechar después ese conocimiento aprendido.
OpenAI — Improving Language Understanding by Generative Pre-Training
Con el tiempo, el acrónimo GPT terminó identificando una familia de Generative Pre-trained Transformers.
Por eso la “T” de GPT —y, por extensión, de ChatGPT— remite directamente a la arquitectura Transformer.
El Transformer también tiene costes y límites
Que una arquitectura haya sido decisiva no significa que sea perfecta.
La autoatención estándar compara posiciones entre sí, lo que hace que su coste aumente rápidamente al crecer la longitud de la secuencia.
Ese problema ha impulsado años de investigación sobre mecanismos de atención más eficientes, ventanas de contexto mayores, memoria, compresión y arquitecturas alternativas.
También se han desarrollado nuevas variantes de posiciones, atención dispersa, mixture of experts y muchas otras técnicas.
Es decir: el Transformer no cerró la investigación. Abrió una etapa nueva.
Por qué este artículo de 2017 sigue siendo relevante
“Attention Is All You Need” importa por tres razones.
La primera es arquitectónica: demostró que era posible modelar secuencias de forma muy eficaz sin recurrencia.
La segunda es computacional: permitió aprovechar mejor el procesamiento paralelo durante el entrenamiento.
Y la tercera es histórica: se convirtió en la base sobre la que se construyeron muchas de las familias de modelos que posteriormente impulsaron la IA generativa.
Eso no significa que toda la inteligencia artificial actual dependa exclusivamente del Transformer.
Visión por computador, aprendizaje por refuerzo, sistemas de recomendación, robótica y otras áreas utilizan arquitecturas y técnicas diferentes.
Pero en el desarrollo reciente de grandes modelos de lenguaje, el Transformer ocupa un lugar difícil de exagerar.
Entender la tecnología también ayuda a usarla mejor
No hace falta conocer las ecuaciones de atención para utilizar ChatGPT, Claude, Gemini o cualquier otro modelo de lenguaje.
Pero comprender los fundamentos cambia la forma de interpretar la tecnología.
Ayuda a entender por qué el contexto importa, por qué un modelo relaciona distintas partes de una instrucción y por qué la cantidad y calidad de la información que proporcionamos condiciona el resultado.
También ayuda a evitar explicaciones mágicas.
Un modelo de lenguaje no “lee” como una persona. Procesa representaciones matemáticas mediante una arquitectura entrenada para aprender patrones y relaciones a enorme escala.
Por eso, cuando trabajamos con estos sistemas, sigue siendo importante dar instrucciones claras, contexto suficiente y criterios de revisión.
En resumen
En 2017, ocho autores publicaron “Attention Is All You Need” y presentaron la arquitectura Transformer.
Su importancia no se reduce a haber inventado la atención. La contribución decisiva fue construir una arquitectura capaz de trabajar principalmente mediante atención, eliminando la recurrencia del núcleo del modelo.
Eso permitió:
- relacionar elementos alejados mediante autoatención;
- procesar muchas posiciones en paralelo;
- entrenar modelos con mayor eficiencia;
- y crear una arquitectura especialmente adecuada para escalar.
Después llegaron el preentrenamiento, modelos cada vez mayores, enormes cantidades de datos, nuevas técnicas de entrenamiento y mucha más capacidad de cálculo.
El Transformer no creó por sí solo la IA generativa actual.
Pero fue uno de esos trabajos que cambiaron la dirección de todo lo que vino después.
Fuente principal: Vaswani et al., Attention Is All You Need, 2017.